การเปลี่ยนผ่านสู่ดิจิทัลได้สร้างความต้องการในการแปลง mp3 เป็นข้อความอย่างที่ไม่เคยมีมาก่อนในหลากหลายอุตสาหกรรม ตั้งแต่นักข่าวที่ถอดเสียงบทสัมภาษณ์ ไปจนถึงนักศึกษาที่เปลี่ยนไฟล์บันทึกการบรรยายให้กลายเป็นโน้ตที่ค้นหาได้ สิ่งที่เคยต้องใช้เวลาพิมพ์ด้วยตนเองหลายชั่วโมง วันนี้สามารถทำได้ภายในไม่กี่นาทีด้วยเครื่องมือถอดเสียงที่ขับเคลื่อนด้วย AI อันล้ำสมัย ซึ่งให้ความแม่นยำที่น่าทึ่งมากกว่า 95% สำหรับไฟล์เสียงที่คมชัด
เทคโนโลยี mp3 to text converter ในปัจจุบันอาศัยอัลกอริทึม machine learning ขั้นสูงและ natural language processing เพื่อแปลงเสียง mp3 เป็นข้อความโดยอัตโนมัติด้วยการแทรกแซงจากมนุษย์เพียงเล็กน้อย เครื่องมือเหล่านี้สามารถรองรับผู้พูดหลายคน เสียงรบกวนพื้นหลัง และสำเนียงที่หลากหลาย พร้อมทั้งยังคงบริบทและรูปแบบการจัดข้อความที่เหมาะสมไว้ได้ ไม่ว่าคุณจะกำลังประมวลผลตอนของพอดแคสต์ ไฟล์บันทึกการประชุม หรือบันทึกเสียงส่วนตัว ความสามารถในการเปลี่ยน mp3 ให้เป็นข้อความได้กลายเป็นสิ่งจำเป็นในการเพิ่มประสิทธิภาพการทำงานและการเข้าถึงข้อมูล
คู่มือฉบับสมบูรณ์นี้จะพาคุณสำรวจโซลูชันถอดเสียงออนไลน์ฟรีที่ดีที่สุดในปัจจุบัน พร้อมเปรียบเทียบฟีเจอร์ ระดับความแม่นยำ และความง่ายในการใช้งาน คุณจะได้เรียนรู้ขั้นตอนการแปลงแบบทีละขั้นตอน ตัวเลือกการปรับแต่งขั้นสูง การใช้งานจริงในหลากหลายอุตสาหกรรม และเคล็ดลับจากผู้เชี่ยวชาญในการเพิ่มความแม่นยำของการถอดเสียง พร้อมทั้งปกป้องความเป็นส่วนตัวและความปลอดภัยของข้อมูลของคุณ
ทำความเข้าใจเทคโนโลยีการแปลง MP3 เป็นข้อความ
การแปลงไฟล์เสียง MP3 ให้เป็นข้อความที่อ่านได้กลายเป็นเครื่องมือสำคัญสำหรับมืออาชีพ นักศึกษา และครีเอเตอร์ทั่วโลก เทคโนโลยีนี้เปลี่ยนคำพูดในไฟล์เสียงของคุณให้เป็นบทถอดเสียงที่ถูกต้อง ช่วยประหยัดเวลาการพิมพ์ด้วยตนเองจำนวนมาก และทำให้เนื้อหาเสียงเข้าถึงได้ง่ายยิ่งขึ้น
การถอดเสียงจากไฟล์เสียงทำงานอย่างไร
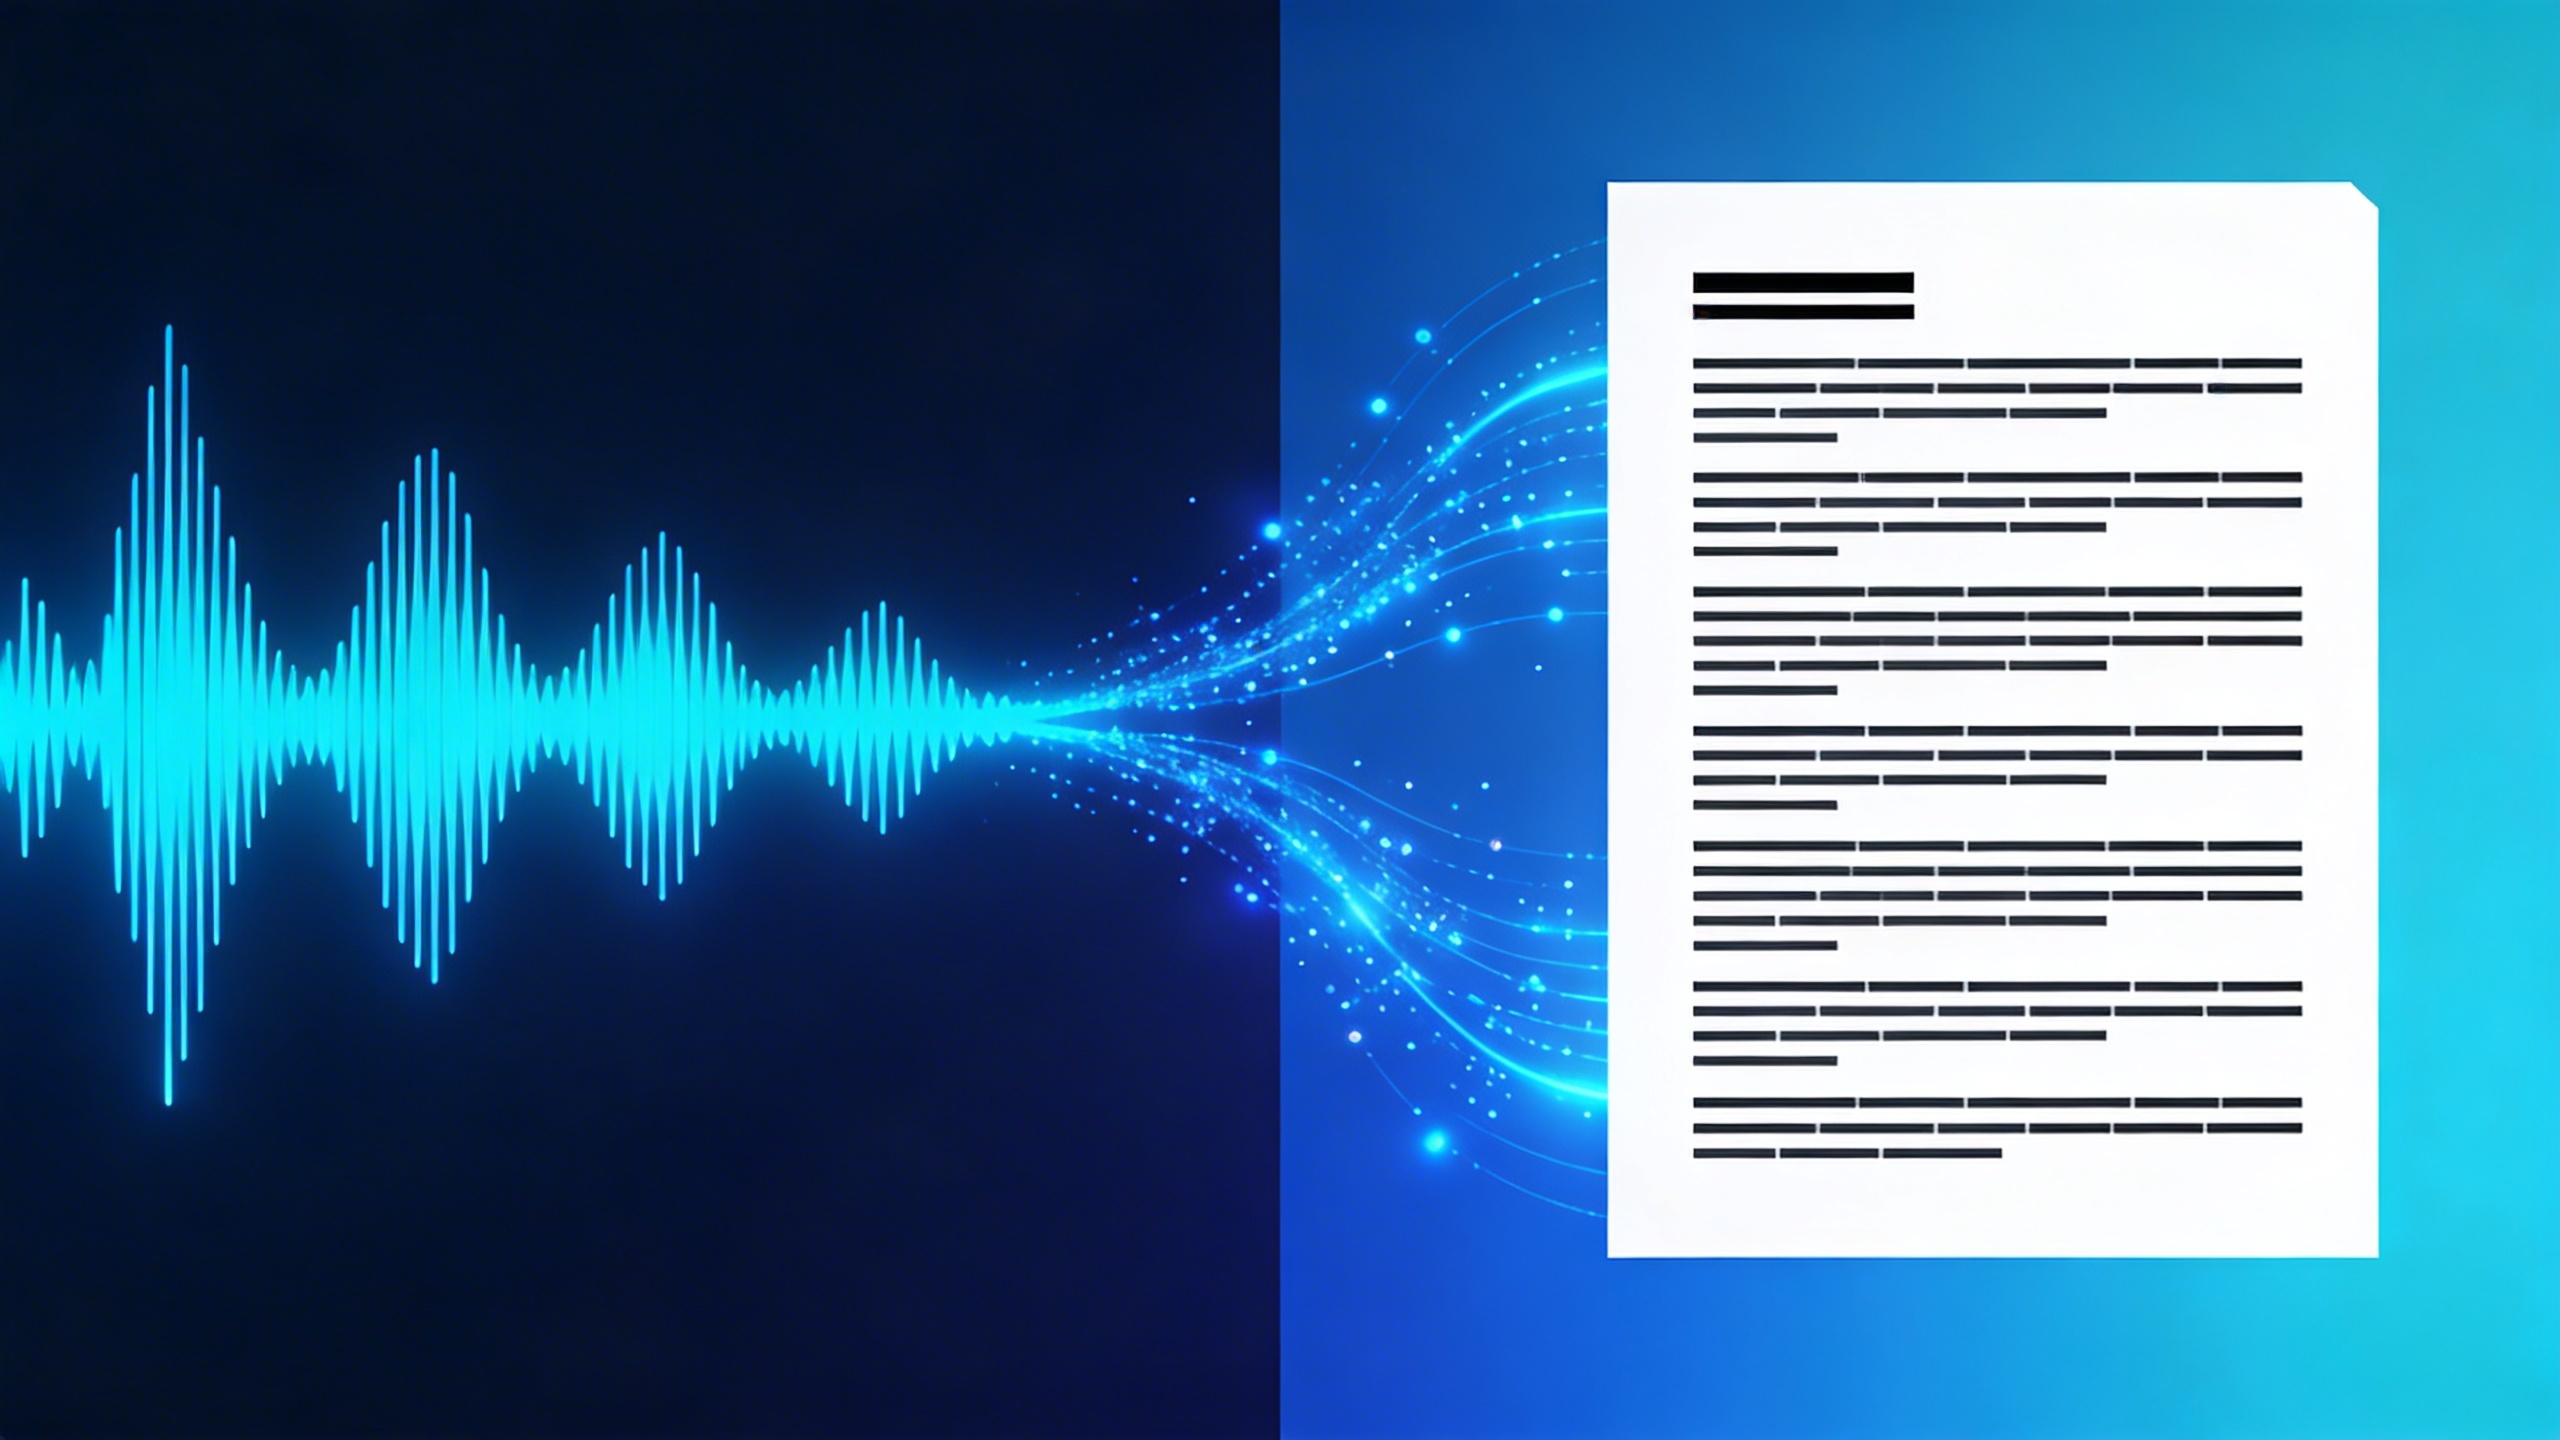
เมื่อคุณแปลง MP3 เป็นข้อความ กระบวนการจะเริ่มต้นจากระบบ automatic speech recognition (ASR) ที่มีความซับซ้อน ซึ่งวิเคราะห์รูปคลื่นเสียงเพื่อระบุรูปแบบการพูด ซอฟต์แวร์จะประมวลผลไฟล์ MP3 ของคุณก่อน โดยแบ่งเสียงออกเป็นช่วงสั้นๆ ซึ่งมักวัดเป็นมิลลิวินาที จากนั้นจึงนำช่วงเหล่านี้ไปเทียบกับฐานข้อมูลขนาดใหญ่ของรูปแบบหน่วยเสียงและโมเดลทางภาษา
mp3 to text converter จะตรวจสอบคุณลักษณะด้านเสียงหลายอย่าง เช่น pitch, tone และ frequency เพื่อแยกความแตกต่างระหว่างผู้พูดแต่ละคน และแยกเสียงพูดออกจากเสียงรบกวนพื้นหลัง อัลกอริทึมขั้นสูงจะระบุขอบเขตของคำและใช้ความเข้าใจตามบริบทเพื่อพิจารณาชุดคำที่มีความเป็นไปได้มากที่สุด แนวทางหลายชั้นนี้ช่วยให้เมื่อคุณแปลงเสียง MP3 เป็นข้อความ ผลลัพธ์ที่ได้ยังคงทั้งความแม่นยำและความอ่านง่าย
ระบบถอดเสียงสมัยใหม่ยังผสาน natural language processing เพื่อทำความเข้าใจไวยากรณ์ เครื่องหมายวรรคตอน และโครงสร้างประโยคอีกด้วย นั่นหมายความว่าบทถอดเสียงสุดท้ายไม่ได้เป็นเพียงชุดคำต่อเนื่องกัน แต่เป็นข้อความที่จัดรูปแบบอย่างเหมาะสมและสะท้อนจังหวะการพูดตามธรรมชาติของมนุษย์
AI เทียบกับระบบรู้จำเสียงพูดแบบดั้งเดิม
ระบบรู้จำเสียงพูดแบบดั้งเดิมพึ่งพากฎที่กำหนดไว้ล่วงหน้าและฐานข้อมูลคำศัพท์ที่จำกัดเป็นอย่างมาก วิธีการแบบเก่าเหล่านี้ต้องอาศัยการฝึกฝนอย่างมากสำหรับเสียงพูดเฉพาะคน และมักมีปัญหากับสำเนียง เสียงรบกวนพื้นหลัง หรือรูปแบบการพูดในการสนทนา ผู้ใช้มักต้องพูดช้าๆ และชัดเจนจึงจะได้ผลลัพธ์ที่ยอมรับได้
โซลูชันที่ขับเคลื่อนด้วย AI ในปัจจุบันซึ่งใช้แปลง MP3 ให้เป็นข้อความนั้นใช้ deep learning neural networks ที่ฝึกจากข้อมูลเสียงที่หลากหลายหลายล้านชั่วโมง ระบบเหล่านี้พัฒนาความแม่นยำอย่างต่อเนื่องด้วยการเรียนรู้จากรูปแบบการพูดใหม่ๆ สำเนียง และความหลากหลายทางภาษา ปัจจุบันอัลกอริทึม machine learning สามารถรองรับผู้พูดหลายคน ภาษาที่ต่างกัน และแม้แต่คำศัพท์เฉพาะทางได้อย่างแม่นยำอย่างน่าประทับใจ
ข้อได้เปรียบสำคัญของการถอดเสียงด้วย AI คือความสามารถในการปรับตัว ขณะที่ระบบแบบดั้งเดิมอาจมีปัญหากับสำเนียงเฉพาะตัวหรือสไตล์การพูดของผู้พูด mp3 to text converter รุ่นใหม่สามารถปรับตัวแบบเรียลไทม์ และเพิ่มความแม่นยำเมื่อประมวลผลไฟล์เสียงมากขึ้น ความสามารถในการเรียนรู้แบบไดนามิกนี้ทำให้เครื่องมือถอดเสียงในปัจจุบันเชื่อถือได้มากกว่าสำหรับการใช้งานในชีวิตประจำวัน
ปัจจัยด้านความแม่นยำและข้อจำกัด
มีหลายปัจจัยสำคัญที่กำหนดว่าระบบสามารถแปลง MP3 เป็นข้อความได้แม่นยำเพียงใด คุณภาพเสียงเป็นปัจจัยที่มีอิทธิพลต่อความแม่นยำของการถอดเสียงมากที่สุด ไฟล์บันทึกที่ชัดเจน มีเสียงรบกวนพื้นหลังน้อย ระดับเสียงสม่ำเสมอ และใช้ไมโครโฟนคุณภาพดี มักให้ความแม่นยำมากกว่า 90% ในทางกลับกัน คุณภาพเสียงที่ไม่ดี มีเสียงก้อง สัญญาณรบกวน หรือเสียงอื่นแทรก อาจลดความแม่นยำลงเหลือ 60% หรือต่ำกว่านั้น
ลักษณะการพูดของผู้พูดเองก็มีบทบาทสำคัญต่อคุณภาพของการถอดเสียงเช่นกัน การออกเสียงชัดเจน ความเร็วในการพูดปานกลาง และสำเนียงมาตรฐาน มักให้ผลลัพธ์ที่ดีกว่า ขณะที่การมีผู้พูดหลายคน สำเนียงหนัก พูดเร็วมาก หรือพูดไม่ชัด ยังคงเป็นความท้าทายต่อให้เป็นระบบที่ล้ำหน้าที่สุดก็ตาม
| ปัจจัย | ความแม่นยำสูง | ความแม่นยำลดลง |
|---|---|---|
| คุณภาพเสียง | บันทึกเสียงชัดเจน ไม่มีเสียงรบกวนพื้นหลัง | มีสัญญาณรบกวน เสียงก้อง หรือเสียงอื่นแทรก |
| รูปแบบการพูด | ความเร็วปานกลาง ออกเสียงชัดเจน | พูดเร็ว พูดไม่ชัด มีการขัดจังหวะ |
| ประเภทเนื้อหา | คำศัพท์ทั่วไป คำพูดเป็นทางการ | ศัพท์เทคนิค สแลง ชื่อเฉพาะ |
การรองรับภาษายังเป็นอีกประเด็นสำคัญเมื่อเลือกเครื่องมือสำหรับแปลงเสียง MP3 เป็นข้อความ แม้ว่าการถอดเสียงภาษาอังกฤษจะมีความแม่นยำที่น่าประทับใจแล้ว แต่การรองรับภาษาอื่นยังแตกต่างกันมาก บางระบบทำได้ดีเยี่ยมกับภาษาที่ใช้กันแพร่หลาย เช่น Spanish, French หรือ Mandarin ขณะที่บางระบบอาจมีปัญหากับภาษาที่พบน้อยกว่าหรือภาษาถิ่นในแต่ละภูมิภาค
ข้อจำกัดทางเทคนิคยังคงมีอยู่ในเทคโนโลยีการถอดเสียงปัจจุบัน คำพ้องเสียง (คำที่ออกเสียงเหมือนกันแต่มีความหมายต่างกัน) อาจทำให้ระบบสับสนและเลือกคำที่ไม่ตรงตามบริบท นอกจากนี้ ชื่อบุคคล ชื่อแบรนด์ และคำศัพท์เฉพาะทางมากๆ อาจยังต้องแก้ไขด้วยตนเองแม้ผ่านการประมวลผลอัตโนมัติแล้วก็ตาม
เปรียบเทียบเครื่องมือแปลง MP3 เป็นข้อความฟรีที่ดีที่สุด
การเลือก mp3 to text converter ที่เหมาะสมขึ้นอยู่กับความต้องการเฉพาะของคุณ ระดับความคุ้นเคยกับเทคโนโลยี และรูปแบบการทำงานที่คุณถนัด การเปรียบเทียบแบบครอบคลุมนี้จะพิจารณาโซลูชันฟรีชั้นนำบนแพลตฟอร์มต่างๆ เพื่อช่วยให้คุณตัดสินใจได้อย่างมั่นใจโดยอิงจากประสิทธิภาพในการใช้งานจริงและประสบการณ์ของผู้ใช้
เครื่องมือแปลงผ่านเบราว์เซอร์
แพลตฟอร์มบนเว็บมอบความสะดวกในการใช้งานได้ทันทีโดยไม่ต้องติดตั้งซอฟต์แวร์ Google’s Speech-to-Text API เป็นพลังขับเคลื่อนเบื้องหลังหลายบริการออนไลน์ ขณะที่เทคโนโลยี Whisper ของ OpenAI ได้ยกระดับความแม่นยำของการถอดเสียงผ่านเบราว์เซอร์อย่างมาก เครื่องมือบนเบราว์เซอร์ส่วนใหญ่สามารถแปลงไฟล์ mp3 เป็นข้อความได้ถึงขนาด 25MB แม้ว่าบัญชีฟรีในระดับพรีเมียมบางแห่งจะขยายได้ถึง 100MB
Otter.ai โดดเด่นด้านความแม่นยำสำหรับเสียงสนทนา โดยทำความแม่นยำได้ประมาณ 85-90% เมื่อใช้กับไฟล์บันทึกที่ชัดเจน แผนฟรีของ Rev.com ให้ผลลัพธ์ระดับมืออาชีพ แต่จำกัดผู้ใช้ไว้ที่หนึ่งชั่วโมงต่อเดือน สำหรับผู้ใช้ที่มองหาการถอดเสียงที่เชื่อถือได้พร้อมการผสาน voice technology, SozAI มอบการแปลง mp3 เป็นข้อความได้อย่างราบรื่นบนหลายแพลตฟอร์มด้วยการประมวลผล AI ขั้นสูง
ความเร็วในการประมวลผลแตกต่างกันอย่างมากในแต่ละโซลูชันบนเบราว์เซอร์ โดยทั่วไปการอัปโหลดแบบง่ายจะประมวลผลได้เร็วกว่าเวลาจริง 2-3 เท่า หมายความว่าไฟล์เสียงความยาว 10 นาทีสามารถแปลงเสร็จได้ใน 3-4 นาที อย่างไรก็ตาม เวลารอคิวในช่วงที่มีการใช้งานหนาแน่นอาจทำให้ระยะเวลารวมยืดออกเป็น 15-20 นาที
โซลูชันซอฟต์แวร์บนเดสก์ท็อป
แอปพลิเคชันเดสก์ท็อปให้คุณควบคุมกระบวนการแปลงได้มากกว่า และมักจัดการไฟล์ขนาดใหญ่ได้มีประสิทธิภาพยิ่งขึ้น Audacity เมื่อนำมาใช้ร่วมกับ speech recognition plugins เป็นโซลูชันฟรีแบบสมบูรณ์ แต่การตั้งค่าต้องอาศัยความรู้ด้านเทคนิค ขั้นตอนการทำงานประกอบด้วยการปรับแต่งเสียง การลดเสียงรบกวน และการ export เป็นรูปแบบที่รองรับก่อนเข้าสู่การถอดเสียง
Windows Speech Recognition ซึ่งติดตั้งมาใน Windows 10 และ 11 สามารถแปลงเสียง mp3 เป็นข้อความผ่านการเล่นเสียงแบบเรียลไทม์ วิธีนี้เหมาะที่สุดกับไฟล์บันทึกคุณภาพสูงและต้องควบคุมการเล่นด้วยตนเอง ผู้ใช้ macOS จะได้ประโยชน์จากฟีเจอร์ dictation ที่ได้รับการปรับปรุง ซึ่งทำงานร่วมกับแอปเล่นเสียงได้อย่างลงตัว
| ซอฟต์แวร์ | ขนาดไฟล์สูงสุด | อัตราความแม่นยำ | ความเร็วในการประมวลผล | ความสามารถในการใช้งานออฟไลน์ |
|---|---|---|---|---|
| Windows Speech Recognition | ไม่จำกัด | 75-80% | เรียลไทม์ | ได้ |
| macOS Dictation | ไม่จำกัด | 80-85% | เรียลไทม์ | จำกัด |
| Audacity + Plugins | ไม่จำกัด | 70-75% | 2x real-time | ได้ |
โซลูชันเดสก์ท็อปโดดเด่นด้านการปกป้องความเป็นส่วนตัว เพราะไฟล์เสียงจะยังคงอยู่บนเครื่องของคุณ ข้อดีนี้มีประโยชน์อย่างยิ่งสำหรับผู้ใช้ที่จัดการเนื้อหาละเอียดอ่อน เช่น ไฟล์บันทึกทางกฎหมาย บันทึกทางการแพทย์ หรือการประชุมธุรกิจที่เป็นความลับ
ตัวเลือกแอปบนมือถือ
แอปพลิเคชันบนสมาร์ตโฟนมอบความสะดวกที่เหนือชั้นสำหรับความต้องการถอดเสียงระหว่างเดินทาง แอป mp3 to text converter บนมือถือส่วนใหญ่อาศัย AI engine บน cloud จึงต้องเชื่อมต่ออินเทอร์เน็ต แต่ให้ความแม่นยำที่ดีกว่าการประมวลผลบนอุปกรณ์
แอป Recorder ของ Google ซึ่งมีให้ใช้งานบนอุปกรณ์ Pixel และโทรศัพท์ Android บางรุ่น รองรับการถอดเสียงแบบเรียลไทม์ด้วยความแม่นยำที่น่าประทับใจสำหรับการบรรยายและการประชุม แอปจะเปลี่ยน mp3 ที่บันทึกไว้เป็นข้อความโดยอัตโนมัติ พร้อมการระบุผู้พูดและเครื่องหมายวรรคตอนพื้นฐาน โดยทั่วไปข้อจำกัดขนาดไฟล์จะอยู่ที่ 50MB ต่อการอัปโหลดหนึ่งครั้ง
ผู้ใช้ iOS ได้ประโยชน์จากฟีเจอร์ถอดเสียงในแอป Voice Memos แม้ว่าความสามารถอาจแตกต่างกันไปตามรุ่นอุปกรณ์และเวอร์ชัน iOS แอปจาก third-party เช่น Transcribe และ Rev Voice Recorder มีฟีเจอร์ที่ครบกว่า รวมถึงการแทรก timestamp และตัวเลือก export ได้หลายรูปแบบ
ความเร็วในการประมวลผลบนมือถือโดยทั่วไปใกล้เคียงกับโซลูชันบนเบราว์เซอร์ที่ระดับ 2-3x real-time อย่างไรก็ตาม ข้อจำกัดของข้อมูลมือถืออาจส่งผลต่อเวลาอัปโหลดสำหรับไฟล์ขนาดใหญ่ แอปส่วนใหญ่มักแนะนำให้ใช้ Wi-Fi สำหรับไฟล์ที่มีขนาดเกิน 10MB
การใช้แบตเตอรี่เป็นอีกปัจจัยสำคัญสำหรับการถอดเสียงบนมือถือ การประมวลผลบน cloud ช่วยลดภาระของอุปกรณ์ ขณะที่โซลูชันที่ประมวลผลบนเครื่องอาจทำให้แบตเตอรี่ลดลงอย่างมากในระหว่างการแปลงไฟล์ที่ยาวนาน ผู้ใช้ที่ต้องแปลง mp3 เป็นข้อความบ่อยๆ ควรคำนึงถึงการจัดการพลังงานและตัวเลือกการชาร์จแบบพกพา
การซิงก์ข้ามแพลตฟอร์มช่วยเพิ่มมูลค่าอย่างมากสำหรับผู้ใช้ที่ทำงานบนหลายอุปกรณ์ แอปที่มีการเชื่อมต่อกับ cloud storage ทำให้สามารถทำงานต่อเนื่องได้อย่างราบรื่นตั้งแต่ขั้นตอนบันทึกบนมือถือไปจนถึงการแก้ไขบนเดสก์ท็อป
ตัวเลือกที่ดีที่สุดขึ้นอยู่กับการสร้างสมดุลระหว่างความต้องการด้านความแม่นยำ ข้อจำกัดของขนาดไฟล์ ความต้องการด้านความเร็ว และประเด็นเรื่องความเป็นส่วนตัว เครื่องมือบนเบราว์เซอร์เหมาะกับผู้ใช้ทั่วไปที่มีความต้องการมาตรฐาน ขณะที่โซลูชันเดสก์ท็อปเหมาะกับผู้ใช้ระดับสูงที่จัดการไฟล์จำนวนมากหรือเนื้อหาละเอียดอ่อน ส่วนแอปมือถือเหมาะอย่างยิ่งสำหรับการถอดเสียงแบบทันทีและการบันทึกเสียงนอกสถานที่
ขั้นตอนการแปลงแบบทีละขั้นตอน
การแปลง mp3 เป็นข้อความต้องอาศัยการเตรียมความพร้อมอย่างรอบคอบและความเข้าใจใน workflow ของการแปลงเพื่อให้ได้ผลลัพธ์ที่ดีที่สุด ไม่ว่าคุณจะกำลังถอดเสียงบทสัมภาษณ์ การบรรยาย หรือบันทึกเสียง การทำตามขั้นตอนอย่างเป็นระบบเหล่านี้จะช่วยให้การถอดเสียงมีความแม่นยำและมีประสิทธิภาพ
การเตรียมไฟล์ MP3 ของคุณ
ก่อนที่คุณจะแปลง mp3 เป็นข้อความ ควรปรับไฟล์เสียงของคุณให้เหมาะสมเพื่อความแม่นยำในการถอดเสียงสูงสุด เริ่มจากตรวจสอบการตั้งค่าคุณภาพเสียง โดย mp3 to text converter ส่วนใหญ่มักทำงานได้ดีที่สุดกับไฟล์ที่บันทึกที่ sample rate 44.1 kHz และ bitrate 128 kbps ขึ้นไป ไฟล์บันทึกคุณภาพต่ำมักให้ความแม่นยำลดลงเนื่องจาก compression artifacts และเสียงรบกวนพื้นหลัง
ปรับแต่งไฟล์เสียงของคุณด้วยการลบเสียงรบกวนพื้นหลังที่มากเกินไป ปรับระดับเสียงให้สม่ำเสมอ และตัดช่วงเงียบที่ไม่จำเป็นออกจากต้นและท้ายไฟล์ หากไฟล์บันทึกของคุณมีผู้พูดหลายคน ลองแบ่งออกเป็นช่วงแยกกัน หรือระบุการเปลี่ยนผู้พูดให้ชัดเจนตลอดทั้งไฟล์ ตัวแปลงส่วนใหญ่รองรับทั้งไฟล์ mono และ stereo ได้ดีพอๆ กัน แต่ไฟล์ mono มักประมวลผลได้เร็วกว่าและใช้ bandwidth ในการอัปโหลดน้อยกว่า
ตรวจสอบความเข้ากันได้ของรูปแบบไฟล์ก่อนดำเนินการต่อ แม้ว่าคุณจะทำงานกับไฟล์ MP3 อยู่แล้ว ก็ควรตรวจสอบให้แน่ใจว่าเครื่องมือแปลงที่คุณเลือกรองรับรูปแบบ encoding นั้นๆ บางแพลตฟอร์มรองรับไฟล์เสียงหลายประเภท เช่น WAV, M4A และ FLAC ซึ่งทำให้คุณยืดหยุ่นมากขึ้นหากต้องแปลงจากแหล่งอื่น
ขั้นตอนการอัปโหลดและประมวลผล
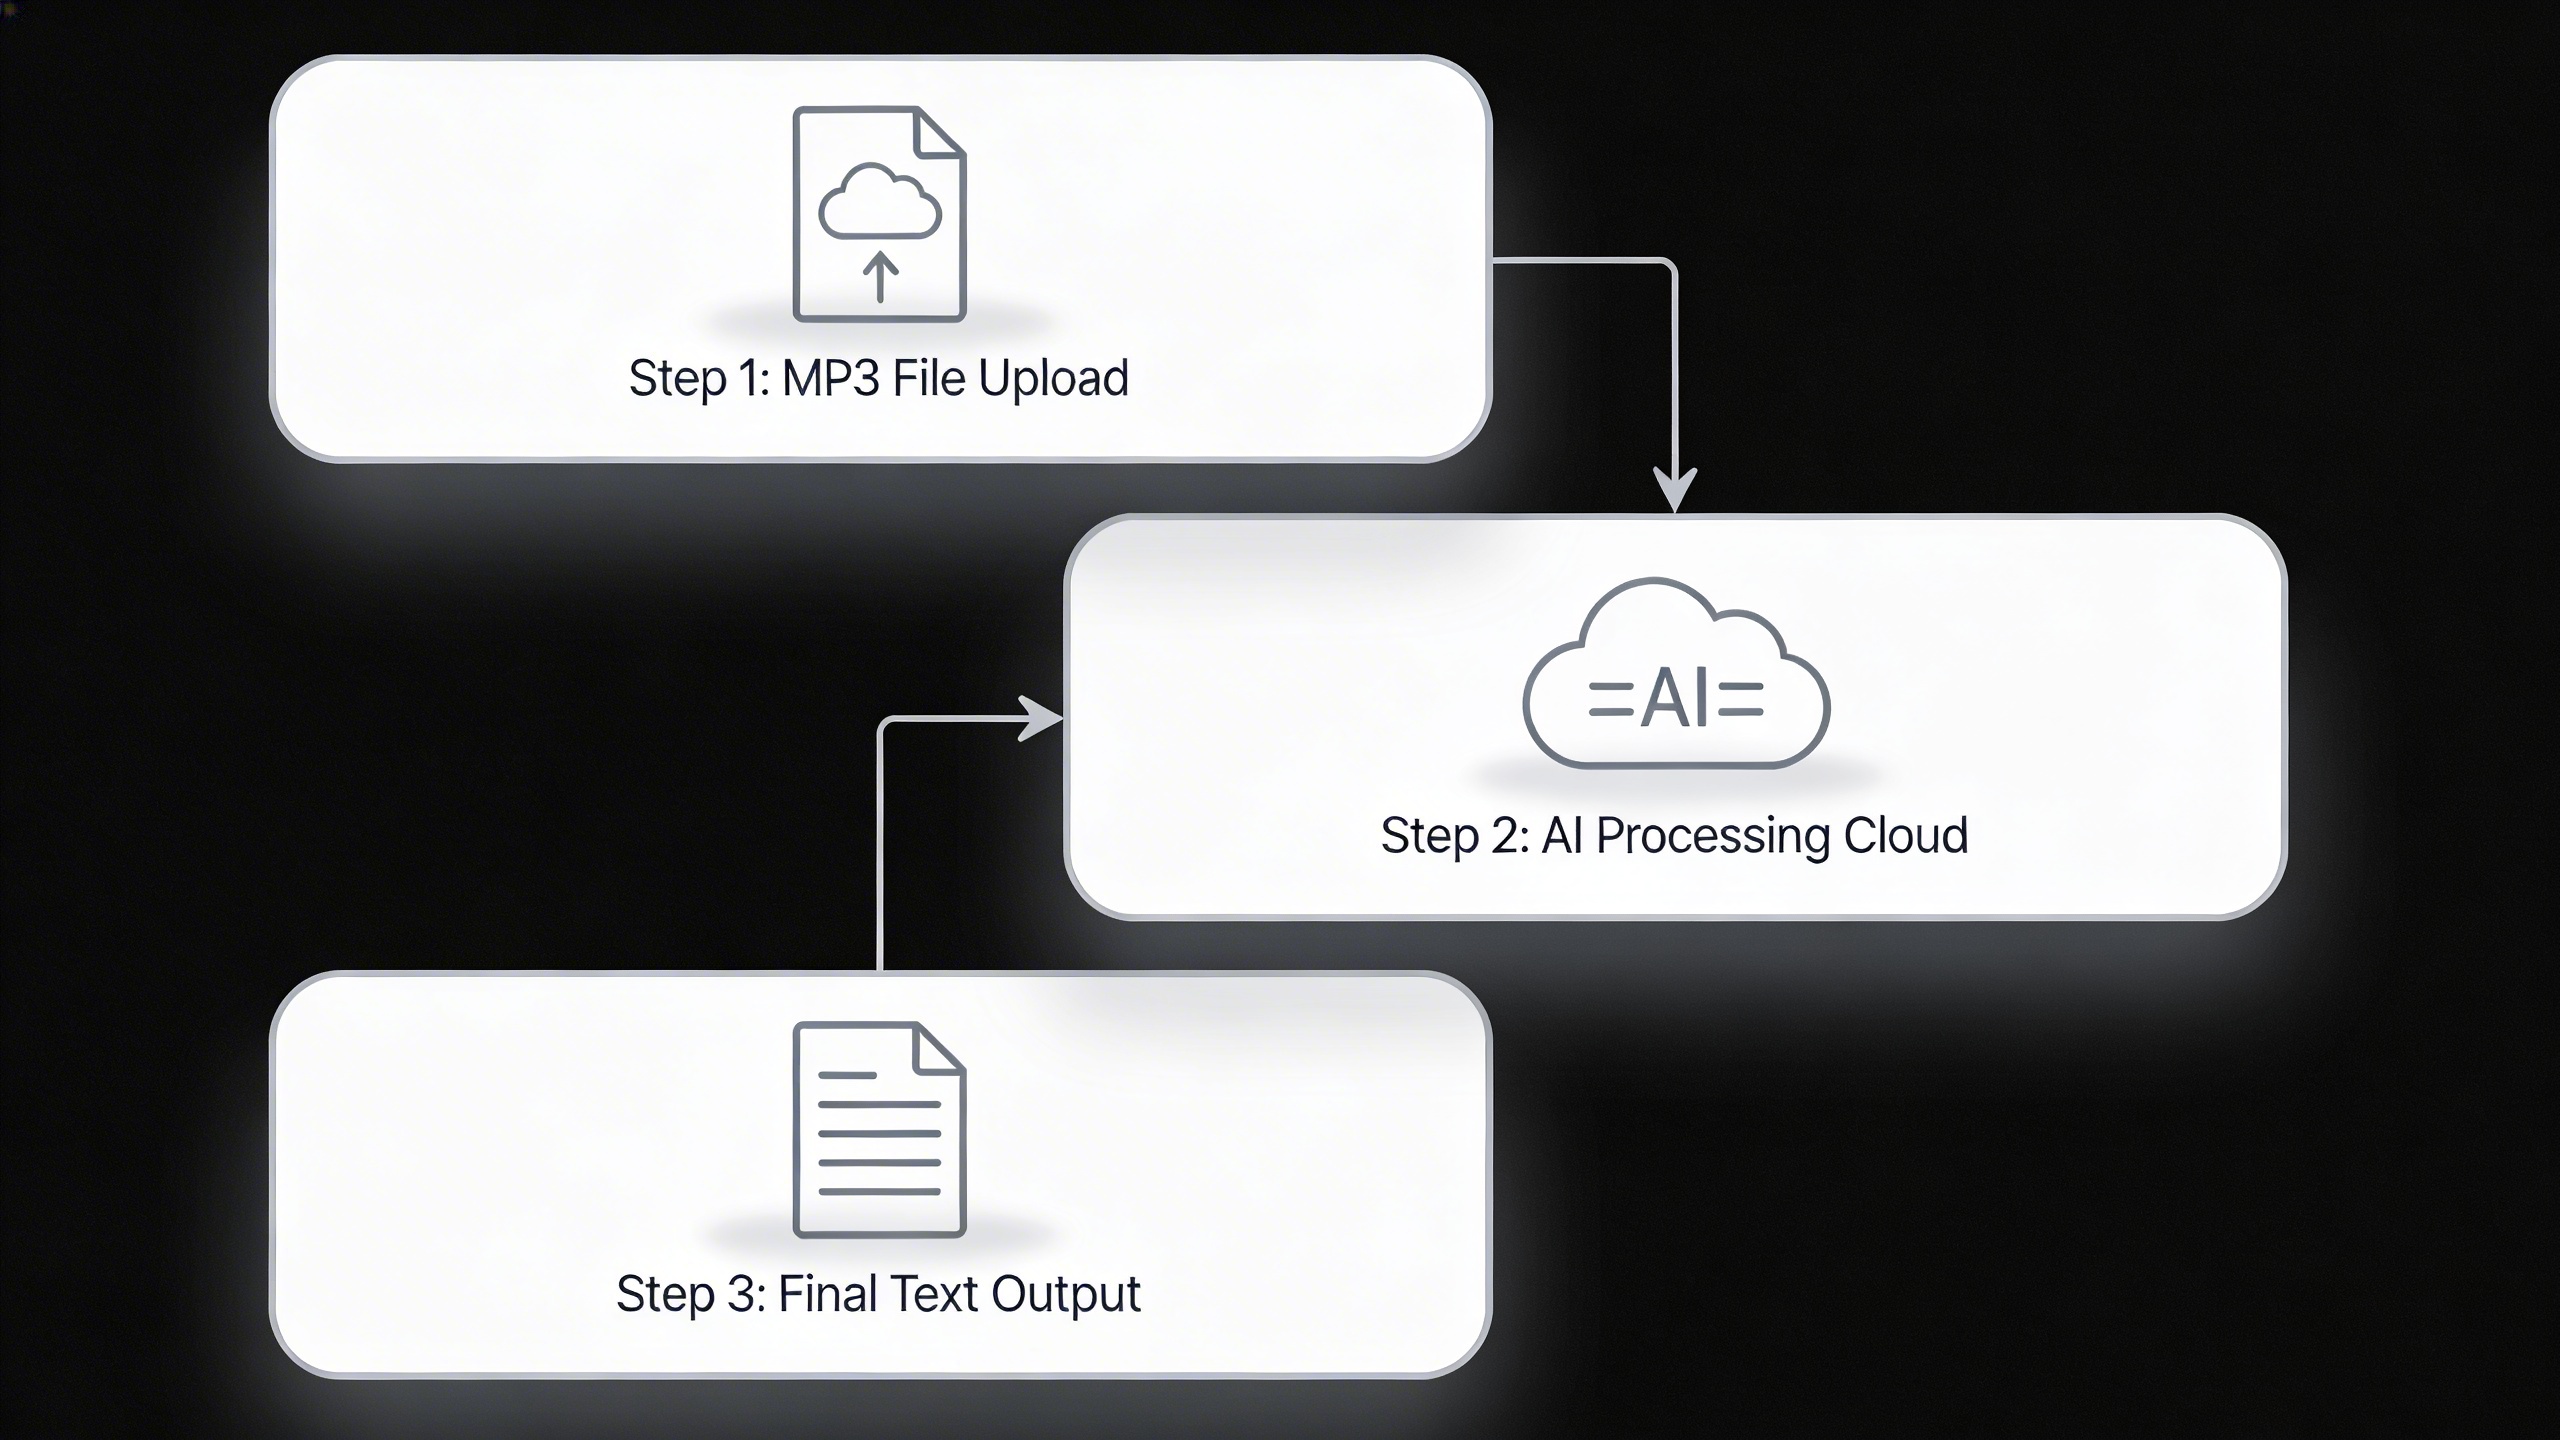
กระบวนการอัปโหลดจะแตกต่างกันไปในแต่ละแพลตฟอร์ม แต่เครื่องมือ mp3 to text converter ส่วนใหญ่มักมี workflow ที่คล้ายกัน เริ่มจากเลือกไฟล์ MP3 ที่คุณเตรียมไว้ผ่านหน้าอัปโหลด โดยฟังก์ชัน drag-and-drop เป็นตัวเลือกที่พบได้บ่อยและมักเร็วกว่าการค้นหาไฟล์แบบปกติ ไฟล์ขนาดใหญ่อาจต้องใช้ความอดทนระหว่างการอัปโหลด โดยเฉพาะเมื่อใช้อินเทอร์เน็ตที่ช้า
ระหว่างการประมวลผล เครื่องมือแปลงหลายตัวจะแสดงตัวบ่งชี้ความคืบหน้าแบบเรียลไทม์เพื่อแสดงเปอร์เซ็นต์ความสมบูรณ์ของการถอดเสียง แพลตฟอร์มขั้นสูงมักมีตัวเลือกการตรวจจับและการเลือกภาษา ดังนั้นควรระบุภาษาของเสียงหากระบบไม่ตรวจพบโดยอัตโนมัติ บางบริการยังมีฟีเจอร์ระบุผู้พูดเพื่อแยกป้ายกำกับเสียงแต่ละคนในไฟล์ที่มีหลายผู้ร่วมสนทนา
เวลาในการประมวลผลขึ้นอยู่กับความยาวไฟล์ คุณภาพเสียง และภาระของเซิร์ฟเวอร์ โดยทั่วไปควรเผื่อเวลาประมาณ 25-50% ของความยาวเสียงสำหรับการประมวลผล เช่น ไฟล์บันทึกความยาว 10 นาที มักใช้เวลา 2-5 นาทีในการแปลงเสียง mp3 เป็นข้อความ บริการแบบพรีเมียมมักให้ความเร็วในการประมวลผลที่สูงกว่าและสิทธิ์เข้าคิวลำดับความสำคัญ
การแก้ไขและ export ผลลัพธ์
เมื่อการแปลง mp3 เป็นข้อความเสร็จสมบูรณ์แล้ว ให้ตรวจสอบบทถอดเสียงอย่างละเอียดเพื่อความถูกต้อง แพลตฟอร์มส่วนใหญ่มาพร้อม editor ในตัวที่ให้คุณแก้ไขคำที่ระบบระบุผิด เพิ่มเครื่องหมายวรรคตอน และจัดรูปแบบป้ายกำกับผู้พูด ควรให้ความสำคัญเป็นพิเศษกับคำศัพท์เทคนิค proper nouns และคำศัพท์เฉพาะทางในอุตสาหกรรม ซึ่งระบบอัตโนมัติมักตีความผิดบ่อย
ใช้ประโยชน์จากฟีเจอร์ timestamp หากมี เพราะเครื่องหมายเหล่านี้ช่วยให้คุณค้นหาช่วงเฉพาะในไฟล์เสียงต้นฉบับเพื่อตรวจสอบได้อย่างรวดเร็ว ตัวแปลงหลายตัวมี confidence score ที่บอกระดับความมั่นใจของระบบต่อคำหรือวลีบางส่วน ช่วยให้คุณจัดลำดับความสำคัญในการแก้ไขจุดที่ไม่แน่นอนได้ง่ายขึ้น
export บทถอดเสียงที่เสร็จสมบูรณ์ของคุณในรูปแบบที่ต้องการ ตัวเลือกที่พบบ่อย ได้แก่ plain text (TXT), Microsoft Word (DOCX), PDF และรูปแบบ subtitle (SRT, VTT) บางแพลตฟอร์มมีตัวเลือกการจัดรูปแบบเพิ่มเติม เช่น การขึ้นย่อหน้า ป้ายกำกับผู้พูด และการใส่ timestamp สำหรับงานระดับมืออาชีพอย่าง SozAI คุณส่งออก TXT, PDF, JSON, SRT และ VTT ได้จากแอป (TXT, SRT และ VTT บนเว็บ) ซึ่งครอบคลุมเวิร์กโฟลว์เอกสารและคำบรรยายส่วนใหญ่
ฟีเจอร์ขั้นสูงและตัวเลือกการปรับแต่ง
mp3 to text converter สมัยใหม่มาพร้อมฟีเจอร์ที่ล้ำกว่าแค่การถอดเสียงพื้นฐาน ช่วยให้ผู้ใช้ดึงคุณค่าสูงสุดจากเนื้อหาเสียงของตนเองได้ ความสามารถขั้นสูงเหล่านี้ตอบโจทย์สถานการณ์ที่ซับซ้อนซึ่งการถอดเสียงแบบมาตรฐานอาจไม่เพียงพอ โดยเฉพาะในสภาพแวดล้อมระดับมืออาชีพและเชิงวิชาการ
การระบุผู้พูดและ timestamp
speaker diarization เป็นหนึ่งในฟีเจอร์ขั้นสูงที่มีประโยชน์มากที่สุดเมื่อคุณแปลง mp3 เป็นข้อความจากไฟล์บันทึกที่มีผู้เข้าร่วมหลายคน เทคโนโลยีนี้สามารถระบุผู้พูดที่แตกต่างกันตลอดทั้งไฟล์เสียงโดยอัตโนมัติ พร้อมติดป้ายกำกับผู้พูดแต่ละคน เช่น “Speaker 1” หรือ “Speaker 2” ตัวแปลงระดับพรีเมียมสามารถแยกแยะผู้พูดจากลักษณะเสียงได้ แม้ในกรณีที่เสียงทับซ้อนกันหรือมีการพูดแทรก
การผสาน timestamp เพิ่มประโยชน์อีกระดับด้วยการระบุช่วงเวลาเฉพาะตลอดบทถอดเสียง เมื่อคุณแปลงเสียง mp3 เป็นข้อความพร้อมฟังก์ชัน timestamp คุณจะได้รับผลลัพธ์ที่แสดงอย่างชัดเจนว่าแต่ละช่วงถูกพูดขึ้นเมื่อใด โดยทั่วไปอยู่ในรูปแบบเช่น [00:02:15] หรือ (2:15) ฟีเจอร์นี้มีคุณค่าอย่างมากสำหรับการตัดต่อพอดแคสต์ การให้การทางกฎหมาย และการสัมภาษณ์วิจัยที่ต้องการความแม่นยำด้านเวลา
เครื่องมือ mp3 to text converter ขั้นสูงบางตัวรวมทั้งสองฟีเจอร์เข้าด้วยกัน โดยให้ timestamp แยกตามผู้พูด ซึ่งไม่เพียงบอกว่าใครเป็นคนพูด แต่ยังบอกอย่างชัดเจนว่าเริ่มและจบการพูดเมื่อใด รายละเอียดในระดับนี้ช่วยเปลี่ยนไฟล์เสียงดิบให้กลายเป็นเอกสารที่มีโครงสร้างและค้นหาได้
การตรวจจับภาษาและการรองรับหลายภาษา
การตรวจจับภาษาอัตโนมัติช่วยลดการคาดเดาเมื่อต้องประมวลผลเนื้อหานานาชาติ ตัวแปลงขั้นสูงจะวิเคราะห์รูปแบบเสียงเพื่อระบุภาษาหลักก่อนเริ่มถอดเสียง ทำให้ได้ความแม่นยำที่เหมาะสมตั้งแต่ต้น ฟีเจอร์นี้มีความสำคัญอย่างมากเมื่อต้องประมวลผลเนื้อหาที่ใช้หลายภาษา หรือเมื่อไม่แน่ใจว่าภาษาต้นฉบับคือภาษาใด
ความสามารถในการถอดเสียงหลายภาษาช่วยให้ผู้ใช้แปลง mp3 เป็นข้อความได้พร้อมกันในหลายสิบภาษา บางแพลตฟอร์มรองรับมากกว่า 100 ภาษาและภาษาถิ่น รวมถึงความแตกต่างในระดับภูมิภาค เช่น Mexican Spanish เทียบกับ Peninsular Spanish เครื่องมือที่ล้ำหน้าที่สุดยังสามารถรองรับ code-switching หรือการสลับภาษาไปมาภายในการสนทนาเดียวกันได้อีกด้วย
การตรวจจับการสลับภาษาแบบเรียลไทม์ถือเป็นแนวหน้าของเทคโนโลยีนี้ เมื่อผู้พูดเปลี่ยนภาษาในระหว่างการสนทนา ระบบขั้นสูงจะปรับโมเดลการประมวลผลโดยอัตโนมัติเพื่อรักษาความแม่นยำข้ามขอบเขตของภาษา
คำศัพท์กำหนดเองและคำศัพท์เฉพาะอุตสาหกรรม
คำศัพท์เทคนิคเป็นความท้าทายสำคัญสำหรับโมเดลการถอดเสียงมาตรฐาน mp3 to text converter ขั้นสูงจึงแก้ปัญหานี้ด้วยฟีเจอร์ custom vocabulary ที่ให้ผู้ใช้อัปโหลดรายการคำศัพท์เฉพาะอุตสาหกรรมได้ บุคลากรทางการแพทย์สามารถเพิ่มชื่อยาและศัพท์กายวิภาคได้ ขณะที่ทีมกฎหมายสามารถใส่คำอ้างอิงคดีและบทบัญญัติกฎหมายได้เช่นกัน
domain adaptation ก้าวไปไกลกว่ารายการคำศัพท์ทั่วไป ด้วยการฝึกโมเดลจากเนื้อหาเฉพาะของอุตสาหกรรมนั้นๆ โมเดลการถอดเสียงด้านกฎหมายเข้าใจขั้นตอนและคำศัพท์ในห้องพิจารณาคดี ขณะที่โมเดลทางการแพทย์สามารถจดจำภาษาวินิจฉัยและแนวทางการรักษาได้ ความเชี่ยวชาญเฉพาะด้านนี้ช่วยเพิ่มความแม่นยำอย่างมากเมื่อต้องประมวลผลไฟล์บันทึกระดับมืออาชีพ
การขยายคำย่อและการจัดรูปแบบตามบริบทเป็นอีกส่วนที่ช่วยยกระดับการจัดการคำศัพท์กำหนดเอง ระบบขั้นสูงสามารถแยกความแตกต่างระหว่าง “AI” ในความหมาย artificial intelligence กับ “eye” ได้จากบริบทการสนทนา พร้อมทั้งจัดรูปแบบคำศัพท์เทคนิคตามมาตรฐานของอุตสาหกรรมโดยอัตโนมัติ
ตัวเลือกการปรับแต่งเหล่านี้ช่วยยกระดับการแปลงเสียงพื้นฐานให้กลายเป็นเครื่องมือจัดทำเอกสารระดับมืออาชีพ ไม่ว่าคุณจะประมวลผลการบรรยายทางวิชาการ การประชุมธุรกิจ หรือการนำเสนอเชิงเทคนิค ฟีเจอร์ขั้นสูงจะช่วยให้ข้อความสุดท้ายสะท้อนทั้งเนื้อหาและบริบทของเสียงต้นฉบับได้อย่างถูกต้อง ทำให้กระบวนการถอดเสียงมีประสิทธิภาพและเชื่อถือได้มากขึ้นสำหรับการใช้งานเฉพาะทาง
กรณีใช้งานและการประยุกต์ใช้
การแปลง MP3 เป็นข้อความมีประโยชน์อย่างมากในหลากหลายอุตสาหกรรมและโปรเจกต์ส่วนตัว การเข้าใจรูปแบบการใช้งานเหล่านี้จะช่วยให้คุณเลือกตัวแปลงที่เหมาะสมและปรับ workflow ให้มีประสิทธิภาพสูงสุด
การใช้งานทางธุรกิจและระดับมืออาชีพ
การถอดเสียงการประชุมเป็นหนึ่งในการใช้งานทางธุรกิจที่มีคุณค่ามากที่สุดสำหรับการแปลง MP3 เป็นข้อความ การบันทึกและถอดเสียงการประชุมช่วยให้มีเอกสารที่ถูกต้องของการตัดสินใจ งานที่ต้องดำเนินการ และการหารือเชิงกลยุทธ์ ผู้เชี่ยวชาญด้านกฎหมายมักแปลงเสียง MP3 เป็นข้อความสำหรับคำให้การ การปรึกษาลูกค้า และกระบวนการในศาล ซึ่งต้องการเอกสารที่แม่นยำสำหรับการเตรียมคดี
การจัดทำเอกสารบทสัมภาษณ์ได้เปลี่ยนแปลงวิธีที่ฝ่ายทรัพยากรบุคคลดำเนินกระบวนการสรรหาบุคลากร การแปลงบทสัมภาษณ์ที่บันทึกไว้เป็นข้อความช่วยให้เปรียบเทียบผู้สมัครได้ง่ายขึ้น และช่วยรักษามาตรฐานการประเมินให้สม่ำเสมอ ทีมขายเองก็ได้รับประโยชน์จากการถอดเสียงการคุยกับลูกค้าเพื่อตรวจจับ pain points และปรับแนวทางสำหรับผู้มุ่งหวังรายต่อไป
บุคลากรทางการแพทย์ใช้เครื่องมือแปลง MP3 เป็นข้อความสำหรับการปรึกษาผู้ป่วยและ medical dictation การใช้งานประเภทนี้ต้องการความแม่นยำสูงและมักต้องอาศัยการจดจำคำศัพท์ทางการแพทย์โดยเฉพาะ ในทำนองเดียวกัน ที่ปรึกษาทางการเงินก็แปลงการประชุมกับลูกค้าเป็นข้อความเพื่อใช้ในการจัดทำเอกสารด้าน compliance และการสื่อสารติดตามผล
วัตถุประสงค์ด้านการศึกษาและการวิจัย
นักศึกษาและนักวิจัยพึ่งพาบริการถอดเสียงการบรรยายอย่างมากเพื่อสร้างสื่อการเรียนที่ค้นหาได้ การแปลงไฟล์บันทึกการบรรยายจาก MP3 เป็นข้อความช่วยให้นักศึกษาทบทวนแนวคิดเฉพาะได้อย่างรวดเร็ว และสร้างคู่มือการเรียนที่ครอบคลุมได้ วิธีนี้มีคุณค่าเป็นพิเศษสำหรับนักศึกษาที่มีความบกพร่องด้านการเรียนรู้ หรือผู้ที่ศึกษาในภาษาที่ไม่ใช่ภาษาแม่
นักวิจัยเชิงวิชาการที่ทำการสัมภาษณ์หรือ focus groups ได้ประโยชน์อย่างมากจากการถอดเสียงอัตโนมัติ การแปลงชั่วโมงของบทสนทนาที่บันทึกไว้เป็นข้อความช่วยเร่งกระบวนการวิเคราะห์ และทำให้นักวิจัยสามารถระบุรูปแบบและธีมต่างๆ ได้มีประสิทธิภาพยิ่งขึ้น งานวิจัยเชิงคุณภาพที่ครั้งหนึ่งเคยต้องใช้เวลาหลายสัปดาห์ในการถอดเสียงด้วยมือ ปัจจุบันสามารถทำเสร็จได้ภายในไม่กี่ชั่วโมง
แอปพลิเคชันเพื่อการเรียนภาษาก็เริ่มนำเทคโนโลยี MP3 เป็นข้อความมาใช้เช่นกัน นักเรียนสามารถถอดเสียงไฟล์เสียงภาษาต่างประเทศเพื่อพัฒนาความเข้าใจ และฝึกการออกเสียงโดยเปรียบเทียบรูปแบบการพูดของตนเองกับเจ้าของภาษา
การสร้างคอนเทนต์และสื่อ
ผู้สร้างพอดแคสต์หันมาแปลง mp3 เป็นข้อความมากขึ้นเพื่อเปิดโอกาสในการนำคอนเทนต์ไปใช้ซ้ำได้หลายรูปแบบ ตอนที่ถอดเสียงแล้วสามารถนำไปทำเป็นบทความบล็อก คอนเทนต์โซเชียลมีเดีย และ show notes ที่ค้นหาได้ ซึ่งช่วยเพิ่มการค้นพบเนื้อหา วิธีนี้ช่วยดึงคุณค่าสูงสุดจากการบันทึกแต่ละครั้ง พร้อมทั้งสนับสนุนการเข้าถึงสำหรับผู้ชมที่มีความบกพร่องทางการได้ยิน
ผู้สร้างวิดีโอใช้เครื่องมือแปลง MP3 เป็นข้อความเพื่อสร้าง subtitle และ closed captions ได้อย่างมีประสิทธิภาพ การดึงเสียงออกจากไฟล์วิดีโอแล้วแปลงเป็นข้อความช่วยให้กระบวนการสร้าง subtitle รวดเร็วกว่าการพิมพ์ด้วยมืออย่างมาก
นักข่าวและนักเขียนคอนเทนต์มักบันทึกบทสัมภาษณ์และแปลงเสียงเป็นข้อความเพื่อนำไปพัฒนาบทความ workflow นี้ช่วยให้ได้คำพูดที่ถูกต้อง พร้อมทำให้นักเขียนโฟกัสกับบทสนทนาได้เต็มที่ แทนที่จะต้องจดโน้ตระหว่างสัมภาษณ์ SozAI มีประสิทธิภาพโดดเด่นเป็นพิเศษสำหรับความต้องการถอดเสียงระดับมืออาชีพเหล่านี้ ด้วยเทคโนโลยี AI ขั้นสูงและการเข้าถึงได้บนหลายแพลตฟอร์ม
เคล็ดลับในการเพิ่มความแม่นยำ
การให้ได้ผลลัพธ์คุณภาพสูงเมื่อคุณแปลง mp3 เป็นข้อความ จำเป็นต้องใส่ใจทั้งไฟล์เสียงต้นทางและ workflow หลังการประมวลผล แม้แต่ตัวแปลงฟรีที่ดีที่สุดก็ยังมีปัญหากับไฟล์เสียงคุณภาพต่ำ ดังนั้นการปรับให้เหมาะสมจึงเป็นสิ่งสำคัญสำหรับผลลัพธ์การถอดเสียงระดับมืออาชีพ
แนวทางปฏิบัติที่ดีที่สุดด้านคุณภาพเสียง
รากฐานของการแปลง mp3 เป็นข้อความอย่างแม่นยำเริ่มต้นจากสภาพแวดล้อมในการบันทึกของคุณ เลือกสถานที่เงียบที่มีเสียงรบกวนน้อยที่สุด เพราะแม้แต่เสียงเบาๆ อย่างเครื่องปรับอากาศหรือเสียงการจราจรก็สามารถส่งผลต่อความแม่นยำของการถอดเสียงได้อย่างมาก วางไมโครโฟนห่างจากผู้พูดประมาณ 6-8 นิ้วเพื่อเก็บเสียงให้ชัดเจนโดยไม่มีเสียงลมหายใจหรือเสียงปะทะของลม
เมื่อทำงานกับไฟล์บันทึกที่มีอยู่แล้ว ควรตรวจสอบให้แน่ใจว่าไฟล์ MP3 ของคุณมี sample rate อย่างน้อย 44.1 kHz และ bitrate 128 kbps ไฟล์เสียงคุณภาพสูงจะให้ข้อมูลกับอัลกอริทึมการแปลงมากขึ้น ส่งผลให้ได้ข้อความที่มีคุณภาพดีกว่า หลีกเลี่ยงการ re-encode ไฟล์หลายครั้ง เพราะการบีบอัดในแต่ละรอบจะลดคุณภาพเสียงและทำให้ความแม่นยำในการถอดเสียงลดลง
เทคนิคการเตรียมไฟล์ก่อนประมวลผล
ก่อนอัปโหลดไฟล์ไปยัง mp3 to text converter ใดๆ ควรใช้เทคนิคปรับแต่งเสียงพื้นฐาน เช่น ใช้ซอฟต์แวร์ลดเสียงรบกวนเพื่อลบเสียงพื้นหลังคงที่อย่างเสียงฮัมหรือเสียงซ่า ปรับระดับเสียงให้สม่ำเสมอตลอดทั้งไฟล์เพื่อป้องกันไม่ให้ช่วงเสียงเบาถูกมองข้ามระหว่างการแปลง
ตัดช่วงเงียบออกจากต้นและท้ายไฟล์บันทึกเพื่อให้ระบบโฟกัสพลังการประมวลผลกับเนื้อหาที่เป็นคำพูดจริง สำหรับไฟล์ที่ยาว ควรพิจารณาแบ่งเป็นช่วงย่อยๆ ช่วงละ 10-15 นาที ตัวแปลงฟรีส่วนใหญ่มักจัดการไฟล์สั้นได้มีประสิทธิภาพกว่า และการแบ่งส่วนยังช่วยให้คุณระบุและประมวลผลซ้ำเฉพาะช่วงที่มีปัญหาได้หากจำเป็น
กลยุทธ์การแก้ไขหลังการแปลง
หลังจากที่คุณแปลงเสียง mp3 เป็นข้อความแล้ว ควรใช้ workflow การพิสูจน์อักษรอย่างเป็นระบบเพื่อจับข้อผิดพลาดในการถอดเสียงที่พบบ่อย อ่านทั้งเอกสารก่อนหนึ่งรอบเพื่อทำความเข้าใจบริบท จากนั้นอ่านรอบที่สองโดยเน้นคำศัพท์เทคนิค proper nouns และตัวเลขที่อัลกอริทึมมักตีความผิด
ใส่ใจเป็นพิเศษกับคำพ้องเสียงและคำที่ออกเสียงคล้ายกัน สร้างพจนานุกรมส่วนตัวของคำที่ใช้บ่อยซึ่งเกี่ยวข้องกับอุตสาหกรรมหรือหัวข้อของคุณ มืออาชีพหลายคนพบว่าการฟังเสียงไปพร้อมกับอ่านข้อความที่ถอดไว้ช่วยให้พบความคลาดเคลื่อนได้เร็วกว่าการตรวจด้วยข้อความอย่างเดียว
กำหนดจุดตรวจสอบคุณภาพตลอดทั้งเอกสารที่ยาว โดยตรวจสอบความแม่นยำทุกๆ สองสามย่อหน้าแทนที่จะรอจนจบ วิธีนี้ช่วยป้องกันไม่ให้ข้อผิดพลาดเล็กๆ สะสมจนบานปลาย และทำให้กระบวนการแก้ไขจัดการได้ง่ายขึ้น สำหรับเอกสารสำคัญ ควรให้บุคคลที่สองช่วยตรวจทานข้อความสุดท้ายเทียบกับไฟล์เสียงต้นฉบับ เพื่อจับข้อผิดพลาดที่คุณอาจมองข้ามไป
ข้อพิจารณาด้านความเป็นส่วนตัวและความปลอดภัย
เมื่อคุณแปลง mp3 เป็นข้อความผ่านบริการออนไลน์ การปกป้องข้อมูลเสียงของคุณถือเป็นเรื่องสำคัญอย่างยิ่ง การทำความเข้าใจผลกระทบด้านความเป็นส่วนตัวและมาตรการความปลอดภัยของแต่ละแพลตฟอร์ม mp3 to text converter จะช่วยให้ข้อมูลสำคัญของคุณได้รับการคุ้มครองตลอดกระบวนการถอดเสียง
มาตรฐานการคุ้มครองข้อมูล
บริการ mp3 to text converter ชั้นนำใช้โปรโตคอลการเข้ารหัสที่แข็งแกร่งในขั้นตอนการอัปโหลดไฟล์ การประมวลผล และการจัดเก็บ การเข้ารหัสแบบ end-to-end ช่วยให้ไฟล์เสียงของคุณปลอดภัยตลอดการแปลงจาก mp3 เป็นข้อความ แพลตฟอร์มที่น่าเชื่อถือส่วนใหญ่มักใช้มาตรฐานการเข้ารหัส AES-256 และการเชื่อมต่อ HTTPS ที่ปลอดภัยเพื่อปกป้องการรับส่งข้อมูล นอกจากนี้ หลายบริการยังมีการลบไฟล์อัตโนมัติภายใน 24-48 ชั่วโมงหลังการแปลง เพื่อลดความเสี่ยงจากการเปิดเผยข้อมูลในระยะยาว
แพลตฟอร์มถอดเสียงระดับมืออาชีพมักมีนโยบายความเป็นส่วนตัวที่ระบุไว้อย่างชัดเจนว่าข้อมูลเสียงของคุณถูกจัดการ ประมวลผล และจัดเก็บอย่างไร มองหาบริการที่ระบุอย่างชัดเจนว่าไม่นำเนื้อหาของคุณไปใช้ในการฝึกโมเดล AI หรือใช้เพื่อวัตถุประสงค์อื่นนอกเหนือจากงานถอดเสียงโดยตรง
การประมวลผลบนเครื่องเทียบกับบน cloud
การเลือกระหว่างการประมวลผลบนเครื่องกับบน cloud ส่งผลอย่างมากต่อระดับความเป็นส่วนตัวของคุณเมื่อแปลงเสียง mp3 เป็นข้อความ โซลูชันบน cloud มอบความสะดวกและพลังการประมวลผลที่สูง แต่ต้องอัปโหลดไฟล์ไปยังเซิร์ฟเวอร์ภายนอก ขณะที่เครื่องมือที่ประมวลผลบนเครื่องจะเก็บข้อมูลทั้งหมดไว้บนอุปกรณ์ของคุณ ลดความเสี่ยงจากการอัปโหลด แต่ก็อาจจำกัดความแม่นยำและความเร็วของการถอดเสียง
หากต้องการความเป็นส่วนตัวสูงสุด ให้พิจารณาโซลูชันอย่าง SozAI ซึ่งถอดเสียงบนคลาวด์ แต่บอกตรงๆ ว่าไฟล์เก็บไว้ที่ไหน (เซิร์ฟเวอร์ของเราในเยอรมนี) และใครเป็นผู้ประมวลผล และให้คุณลบการบันทึกได้เอง
ข้อกำหนดด้านการปฏิบัติตามมาตรฐาน
การปฏิบัติตาม GDPR กลายเป็นสิ่งจำเป็นสำหรับ mp3 to text converter ที่ให้บริการแก่ผู้ใช้ในยุโรป บริการที่สอดคล้องตามข้อกำหนดจะต้องมีกลไกการขอความยินยอมที่ชัดเจน ตัวเลือกการโอนย้ายข้อมูล และสิทธิ์ในการลบข้อมูล องค์กรด้านการดูแลสุขภาพที่แปลงไฟล์บันทึกทางการแพทย์จำเป็นต้องใช้โซลูชันที่สอดคล้องกับ HIPAA ขณะที่สถาบันการเงินต้องการแพลตฟอร์มที่ได้รับการรับรอง SOC 2
ผู้ใช้ระดับองค์กรควรตรวจสอบว่าบริการถอดเสียงที่เลือกมีใบรับรองการปฏิบัติตามมาตรฐานที่เหมาะสม มีการตรวจสอบความปลอดภัยอย่างสม่ำเสมอ และมี data processing agreements รองรับ ปัจจุบันหลายแพลตฟอร์มมีแพ็กเกจระดับองค์กรโดยเฉพาะพร้อมฟีเจอร์ความปลอดภัยที่ยกระดับขึ้น เช่น การเชื่อมต่อ single sign-on, audit logs และนโยบายการเก็บรักษาข้อมูลแบบกำหนดเองตามความต้องการขององค์กร